Quand un agent IA lit vos données de relation client pour la première fois, il ne flatte pas. Il compte. Ce qu'il trouve, les équipes le savent depuis longtemps : elles n'avaient simplement pas encore osé le dire à voix haute.
Aylina by KlintSeptembre 2026Lecture · 7 min
Section 01
Le paradoxe des données que tout le monde connaît
En 2026, la quasi-totalité des ETI françaises disposent d'un CRM. Elles y investissent depuis des années. Elles ont formé leurs commerciaux, défini leurs processus, déployé des connecteurs. Et pourtant, quand on leur demande si leurs données sont fiables, la réponse hésite.
76%
des entreprises ont moins de 50 % de leurs données CRM exactes et complètes.
Validity, State of CRM Data Management 2025
37%
des utilisateurs CRM ont perdu du chiffre d'affaires directement à cause de mauvaises données.
Validity, State of CRM Data Management 2025
45%
des données CRM ne sont pas préparées pour l'IA.
Validity, State of CRM Data Management 2025
Ces chiffres ne sont pas nouveaux. Ce qui est nouveau, c'est ce qu'on en fait : pendant des années, l'état des données était un sujet de DSI. Aujourd'hui, c'est le premier sujet que l'IA soulève.
« 87 % des dirigeants data jugent leurs données prêtes pour l'IA. 43 % des mêmes dirigeants, dans la même étude, citent la donnée comme premier frein à leurs projets IA. »
· Drexel LeBow & Precisely, 2026 · 505 dirigeants data dont 51 en France
Cette contradiction n'est pas anecdotique. Elle dit quelque chose d'important : les organisations savent que leurs données sont imparfaites, mais elles ont appris à vivre avec. L'IA, elle, n'apprend pas à vivre avec. Elle signale.
Section 02
Ce que Claude voit en premier
Depuis le déploiement du protocole MCP (Model Context Protocol) d'Anthropic, un agent IA peut se connecter directement aux bases de données d'un CRM, d'un ERP ou d'un outil de gestion, en temps réel. C'est un standard ouvert : l'agent interroge les données là où elles se trouvent, sans export, sans copie.
Ce que cela change concrètement : quand un agent lit un CRM pour la première fois, il ne fait pas de tri. Il lit tout. Et il est honnête sur ce qu'il trouve.
Voici ce qu'un agent détecte dans les premières minutes d'une connexion à un CRM d'ETI :
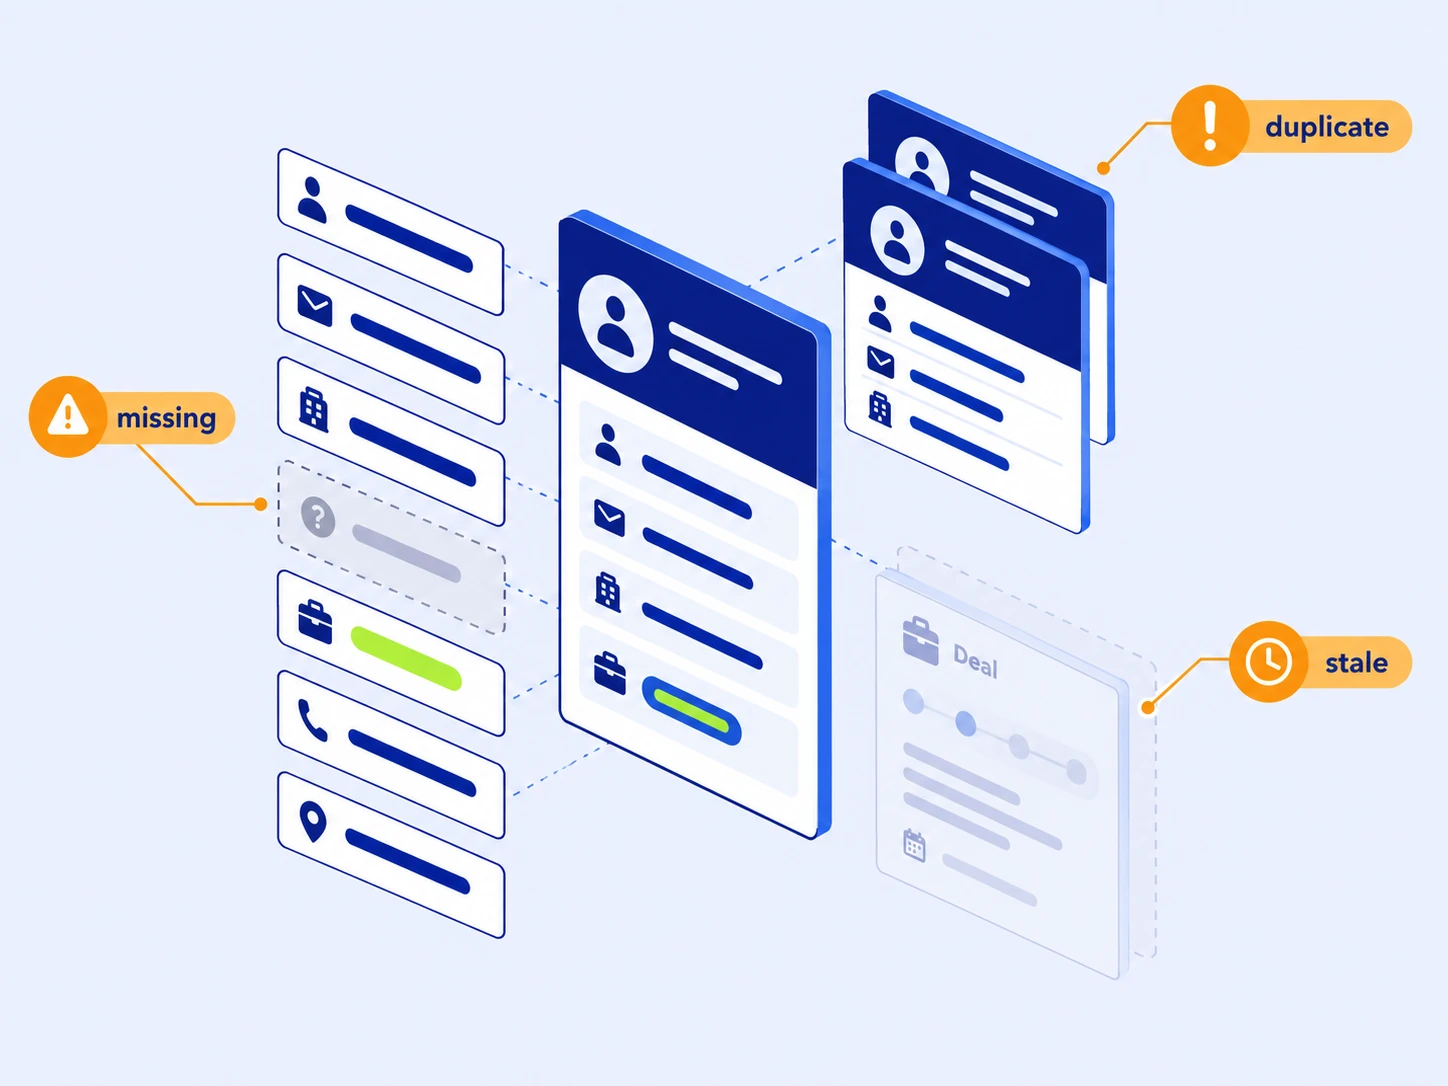
Des contacts fantômes : des fiches créées lors d'un salon il y a trois ans, sans email, sans interaction depuis. Toujours là.
Des doublons fragmentés : le même interlocuteur créé deux fois, avec des historiques d'échanges répartis sur deux fiches. L'agent ne sait pas lequel est le bon.
Des opportunités mal qualifiées : des deals au stade négociation depuis 14 mois, sans activité récente, sans montant défini. Ce n'est pas un pipeline. C'est une liste de vœux.
Des champs stratégiques vides : la fonction du contact, le secteur, le décideur. Précisément les champs dont dépend la personnalisation qu'on voulait confier à l'IA.
Les chiffres confirment l'ampleur. En moyenne, 10 à 30 % des fiches d'un CRM d'entreprise contiennent des doublons, complets ou partiels. Sur certaines bases B2B non entretenues, ce taux monte à un contact sur quatre.
« 19 % des décideurs présentent ou agissent fréquemment sur une recommandation IA dont ils ont ensuite suspecté la fiabilité à cause des données sous-jacentes. 43 % supplémentaires disent que cela arrive de temps en temps. »
· Validity, State of CRM Data Management 2026 · publié le 25 août 2026
Dit autrement : dans les organisations qui ont déjà connecté l'IA à leurs données, plus de 6 décideurs sur 10 savent qu'ils agissent parfois sur de mauvaises informations. Ils le font quand même.
Section 03
Pourquoi c'est une bonne nouvelle
Ce serait une erreur de lire ces données comme un réquisitoire contre le CRM ou contre l'IA. C'est exactement l'inverse.
Le désordre dans les données de relation client n'est pas né avec l'IA. Il existait avant, il était simplement invisible : les commerciaux connaissaient leurs contacts par coeur, les équipes marketing contournaient les champs vides, les managers lisaient entre les lignes de leurs tableaux de bord. Le problème était là, structurel, muet.
L'IA le rend visible, mesurable, et donc traitable.
C'est précisément ce que montre l'écart entre les organisations qui gagnent avec l'IA et celles qui s'arrêtent au pilote :
73%
des entreprises qui ont transformé leur performance avec l'IA ont refondu leurs processus et leur donnée avant d'outiller.
McKinsey, State of AI, juin 2026 · 1 719 répondants, 97 pays
Contre 25 % seulement chez celles qui ont simplement ajouté des outils IA sur des processus et des données existants. L'écart est brutal.
L'IA agit comme un test de charge. Elle révèle ce qui tenait à l'habitude humaine et ce qui tient vraiment. Un commercial qui connaît ses clients par coeur compense naturellement les lacunes de sa base. Un agent IA, non. Il travaille avec ce qu'il voit.
La question n'est donc plus « est-ce que nos données sont parfaites ? » Elles ne l'ont jamais été. La question est : qui va s'en occuper en premier, et avec quelle méthode ?
Section 04
Ce qu'Aylina construit sur ce constat
Aylina by Klint s'appuie sur 26 ans de projets SI et CRM pour des ETI françaises. Ce que ces projets ont appris à Klint : les échecs ne viennent pas de la technologie. Ils viennent de la donnée et du processus. L'IA ne fait pas exception.
C'est pourquoi Aylina structure son approche autour de trois chantiers interdépendants.
Chantier 01
Plateforme IA d'entreprise
Un agent déployé sans gouvernance, c'est un risque silencieux. Qui l'a créé ? Quel système accède-t-il ? Quel coût génère-t-il ? Aylina fournit un point d'entrée unique : inventaire des agents, identités et droits rattachés à l'annuaire existant, suivi des coûts, audit complet. Agnostique en termes de modèle : le LLM change, l'architecture reste.
Chantier 02
Transformation des processus métiers
L'erreur classique est de brancher un agent sur un processus existant sans le redessiner. L'agent fait alors ce que les équipes faisaient : il contourne les données manquantes, il assume des règles implicites, il produit des résultats qui paraissent raisonnables mais ne sont pas auditables. Aylina redessine le processus avant d'outiller. Ce qui s'arrête, ce qui se simplifie, quelles validations tombent. Puis on met en production, pas en démonstration.
Chantier 03
Qualité de données et socle data
Rassembler la donnée, c'est le moment où les divergences entre le CRM, l'ERP et la BI deviennent visibles. Pas pour pointer des responsables : pour construire un point de vérité commun. La qualité progresse dans ce référentiel d'abord, et les agents héritent de sources fiables. Aylina propose un Diag Data x IA : un audit structuré de la donnée existante, qui identifie les cas d'usage IA réellement activables aujourd'hui, ceux qui nécessitent un travail préalable, et ceux à déprioriser. Résultat visible en moins de trois mois.
Illustration 5
Schéma : les 3 chantiers Aylina (01 Plateforme IA · 02 Processus métiers · 03 Qualité data) avec flèches de dépendance. Style épuré.
Section 05
Ce que ça donne en production
Cas client
Immobilier · Automatisation des demandes techniques
Ce grand acteur de l'immobilier coté a engagé Aylina sur l'automatisation du traitement des demandes techniques. L'agent, connecté aux données internes, traite 100 % des demandes entrantes et atteint plus de 90 % de fiabilité sur la qualification et l'orientation des tickets.
Le point de départ n'était pas la technologie. C'était la donnée : cartographier ce qui existait, identifier les divergences entre les systèmes, construire un référentiel stable avant de brancher le premier agent.
>90%
de fiabilité
100%
des demandes traitées
Cas client
Télécommunications · Quatre agents en production CRM
Cet opérateur de télécommunications a déployé quatre agents directement connectés à son CRM. Leurs rôles : scoring NPS en temps réel, comparaison automatique de versions de contrats, enrichissement de fiches contact, et recherche avancée dans l'historique client.
Ce cas est notable parce que les quatre agents exploitent des données CRM qui existaient déjà, mais n'étaient pas utilisées à leur plein potentiel. La donnée était là. Ce qui manquait, c'était la couche de qualification et le processus redessiné autour.
Scoring NPSComparaison de contratsEnrichissement de ficheRecherche avancée
L'IA comme contrat de vérité
Ce que Claude voit dans votre CRM, vos équipes le savent.
Elles l'ont toujours su, à leur manière. La différence, c'est que l'agent ne fait pas semblant de ne pas l'avoir vu.
C'est inconfortable. C'est aussi le début du seul travail qui compte : construire des données sur lesquelles on peut vraiment compter, et des agents qui méritent la délégation qu'on leur confie.
Les organisations qui avancent vite ne sont pas celles qui ont les meilleures données de départ. Ce sont celles qui ont accepté de regarder la réalité en face, tôt, avec méthode.
L'IA n'est pas un problème de technologie. C'est un contrat de vérité entre une organisation et ses propres données.
Vous voulez savoir ce que Claude verrait dans vos données CRM ?